


I teknikbranschen kan du knappast ha en konversation utan att någon nämner slutledning, artificiell intelligens (AI) och maskininlärning (ML). Det är dock viktigt att notera att även om alla dessa termer är sammankopplade, skiljer de sig också avsevärt.
I den här artikeln förklarar vi de grundläggande skillnaderna och betonar vikten av att använda tensorbearbetning-baserad edge AI-teknik, särskilt i edge och inbyggda system. Jämfört med lösningar baserade på grafikprocessorer (GPU) erbjuder tensorprocessorer (TPU) effektivare och kostnadseffektivare prestanda. Vi kommer också att ge några exempel på användningsområden som illustrerar var du kan stöta på avancerade AI-lösningar i framtiden.
Grunderna i ML och inferens
ML hänvisar till metodiken för träningsmodeller som använder representativa data för att göra det möjligt för maskiner att lära sig hur man utför uppgifter. Denna process kan vara mycket beräkningsintensiv och generera biljoner operationer per ny träningsdatapunkt. Utbildningsprocessens iterativa karaktär, i kombination med de enorma utbildningsdatauppsättningar som krävs för att uppnå hög noggrannhet, driver efterfrågan på extremt hög-flytande-bearbetning. ML-utbildning implementeras bäst som datacenterinfrastruktur, där höga kapital- och driftskostnader kan motiveras genom att amortera dem på ett flertal kunder.
Inferens innebär att använda tränade modeller för att generera potentiella matchningar för nya data som är relevanta för de representativa data som modellen tränades på. Inferens syftar till att leverera snabba svar inom millisekunder. Exempel på slutledningar inkluderar taligenkänning,-realtidsöversättning av språk, maskinseende och beslut om optimering av annonsinfogning. Även om slutledning kräver bara en bråkdel av den processorkraft som behövs för utbildning, överstiger den fortfarande långt vad traditionella centralprocessorbaserade-system kan leverera, särskilt för datorseendeapplikationer. Det är därför så många företag vänder sig till tensor-baserade accelerationslösningar-oavsett om det är IP på SoCs eller som i-systemacceleratorer-för att uppnå de svarstider på under{10}}undersekunder som krävs vid kanten. Verkligheten är att det inte är särskilt användbart att spendera ens en minut eller några sekunder på att bearbeta bilder i ett visionsystem. Industriella visionsystem söker bearbetningshastigheter på millisekund-nivå.
Separera träning och slutledning
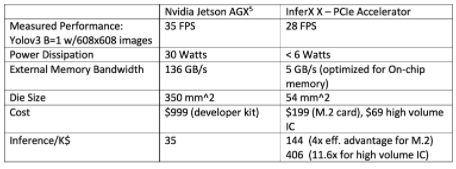
Att distribuera samma hårdvara som används för utbildning för att hantera slutledningsarbetsbelastningar kan resultera i att-överprovisionering av slutledningsmaskiner med acceleratorer och CPU-hårdvara. GPU-lösningar som utvecklats för ML under det senaste decenniet är inte nödvändigtvis det optimala valet för stor-distribution av ML-inferensteknologier. Diagrammet nedan illustrerar perfekt jämförelsen mellan TPU-acceleratorer och GPU-acceleratorer. Det visar tydligt att TPU-acceleratorer ger lägre strömförbrukning, lägre kostnader och högre effektivitet jämfört med GPU-baserade AGX-lösningar, samtidigt som de ger övertygande prestandanivåer för slutledningstillämpningar.
En annan viktig faktor när man närmar sig ML-utbildning och slutledningslösningar är mjukvarumiljön. Idag används många populära bibliotek, som CUDA för NVIDIA GPU:er, ML-ramverk som TensorFlow och PyTorch, optimerade plattformsmodellbibliotek som Keras och mer. Dessa verktygssatser är viktiga för att utveckla och träna ML-modeller, men slutledningsapplikationer kräver en annan, mindre uppsättning mjukvaruverktyg.
Inferensverktygssatser fokuserar på att köra modeller på målplattformar. De stöder portering av tränade modeller till plattformar, vilket kan innebära vissa operatörstransformationer, kvantisering och värdintegreringstjänster. Detta representerar dock en relativt enkel uppsättning funktioner jämfört med de som krävs för modellutveckling och utbildning.
Inferensverktyg tjänar på att börja med en standardiserad representation av modellen. Open Neural Network Exchange (ONNX) är standardformatet för att representera ML-modeller. Som namnet antyder är det en öppen standard som hanteras som ett Linux Foundation-projekt. Teknologier som ONNX möjliggör frikoppling av utbildnings- och slutledningssystem, vilket ger utvecklare friheten att välja olika optimerade plattformar för var och en.
Exempel på visuella applikationer
Allt eftersom ML- och inferensprocessorteknologier fortsätter att avancera och utvecklas, ökar applikationerna. Nedan är bara några ställen där du kan komma att stöta på den här tekniken i framtiden.
Edge-servrar i företag som fabriker, sjukhus, butiker och finansiella institutioner. Till exempel, i industriella miljöer, kan AI hjälpa till med lagerhantering, defektdetektering och till och med förutsägande underhåll innan problem uppstår. I detaljhandeln möjliggör den funktioner som ställningsuppskattning, med hjälp av datorseende för att upptäcka och analysera mänsklig hållning. Data från den här analysen hjälper fysiska-och-återförsäljare att bättre förstå mänskligt beteende och fottrafik i sina butiker, vilket gör att de kan optimera butikslayouter för maximal försäljning och kundnöjdhet.
Hög-precision/hög-kvalitetsavbildning för applikationer inklusive robotik, industriell automation/inspektion, medicinsk bildbehandling, vetenskaplig bildbehandling, övervaknings- och objektigenkänningskameror och fotonik. Maskininlärningsmetoder har till exempel visat förmågan att upptäcka cancer genom att behandla digitala röntgenstrålar. Denna process innefattar utveckling av en ML-modell utformad för att behandla röntgenbilder, vanligtvis med hjälp av tränade semantiska segmenteringsalgoritmer för att identifiera cancerskador. Under utbildningen används cancerbilder som identifierats av radiologer för att lära nätverket vad som inte är cancer, vad som är cancer och hur olika typer av cancer uppträder. Ju mer en ML-modell tränas, desto bättre blir den på att maximera korrekta diagnoser och minimera feldiagnoser. Detta innebär att maskininlärning inte bara förlitar sig på intelligent modelldesign utan lika mycket på enorma mängder (tiotusentals till miljoner) noggrant kurerade dataexempel där cancer har identifierats på ett sakkunnigt sätt.
Smarta kundvagnar-Flera företag utvecklar och distribuerar intelligenta shoppingsystem som känner igen produkter inte genom sina UPC-streckkoder, utan genom det visuella utseendet på själva förpackningen. Den här funktionen gör det möjligt för kunder att enkelt lägga varor i kundvagnen eller i kassasystemet utan att behöva hitta UPC-koden och skanna den med en UPC-laserskanner. Denna teknik gör shoppingprocessen mer exakt, snabbare och bekvämare.
Att fatta rätt beslut
Företag måste utvärdera alla tillgängliga lösningar idag och välja den optimala utifrån deras specifika användningsfall. De kan inte heller helt enkelt anta att alla AI-lösningar är bäst implementerade på GPU-enheter, eftersom TPU-baserade lösningar erbjuder högre bearbetningseffektivitet och lägre kiselanvändning, vilket minskar strömförbrukningen och kostnaderna.